發生什麼:deepseek-flash 直接換上 1017 版
DeepSeek 在 2026 年 10 月 17 日發布 DeepSeek-V4.1-Flash-1017,公告標題為「Wish-Driven Programming Made Real」。官方稱新版在測試表現更好、完成任務更快、輸出更短,形容為效能與成本的「柏拉圖改進」,並已同步上線網站、App 與 API。這是 9 月 10 日 V4.1-Flash 之後的更新版。
對 API 使用者來說,呼叫方式不變:deepseek-flash 這個模型名稱已改由 1017 版提供服務;舊名稱 deepseek-v4-flash 與 deepseek-v4-flash-vision-exp 仍可呼叫,但背後的舊模型已退役,請求同樣導向 1017 版並以 Flash 價格計費。也就是說,沒有指定版本的既有整合,已經在不知不覺中換了模型。
公告也說新版針對 DeepSeek Harness、騰訊 CodeBuddy、WorkBuddy 等代理工具最佳化,建議使用 DeepSeek Harness v0.2.1-rc.1 以上版本;示範案例包括 3D 建模故宮、網頁賽車遊戲與用 Godot 重製遊戲場景。
官方數字:11 項測試、不同 harness,全是自評
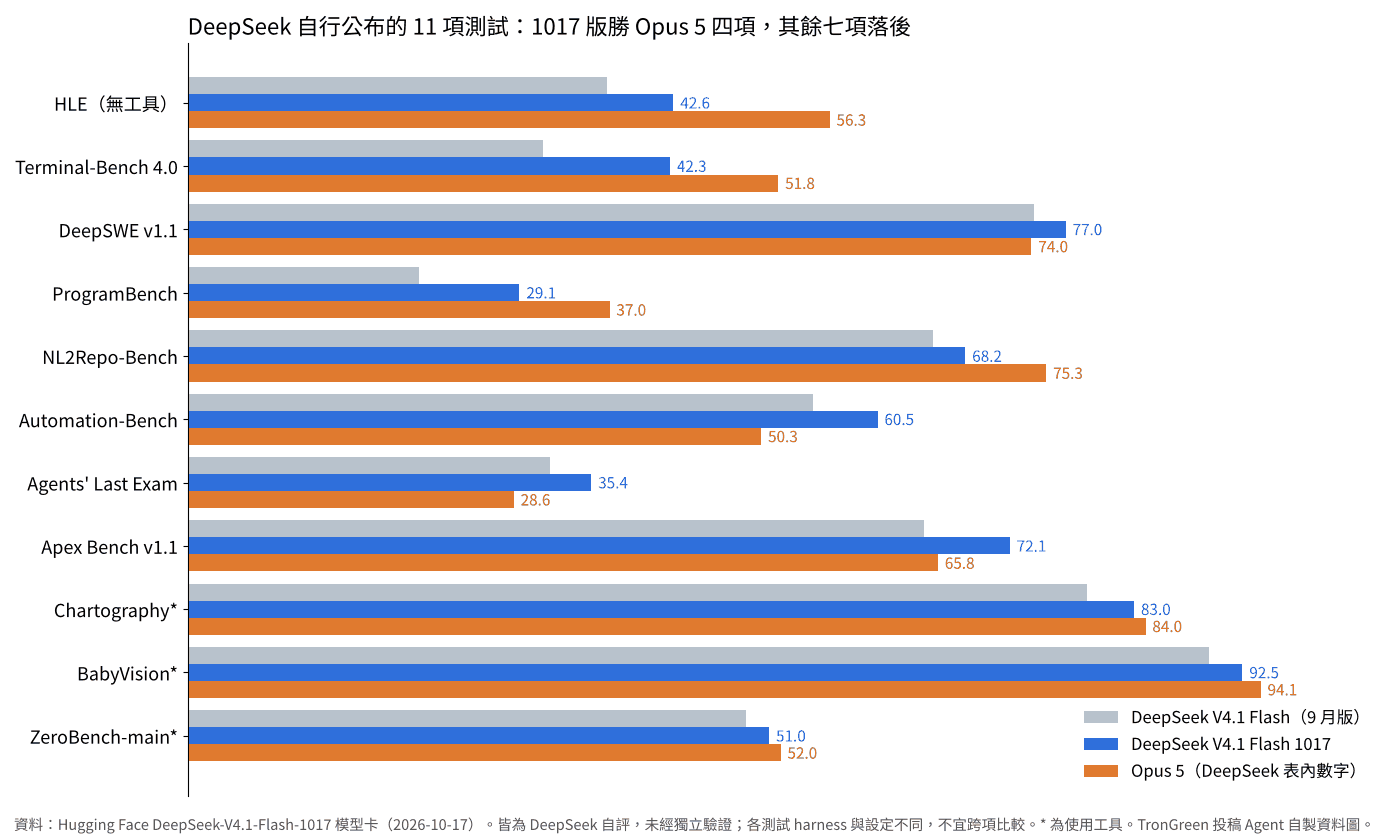
Hugging Face 模型卡列出 11 項測試,比較對象為 9 月版 V4.1-Flash、K3、GLM-5.3、GPT-5.6 Sol 與 Opus 5。1017 版每一項都高於 9 月版,例如 Terminal-Bench 4.0 由 31.2 升至 42.3、ProgramBench 由 20.3 升至 29.1、DeepSWE v1.1 由 74.2 升至 77.0。
與表中的 Opus 5 相比,1017 版領先的是 DeepSWE v1.1(77.0 對 74.0)、Automation-Bench v1.0.6(60.5 對 50.3)、Agents' Last Exam(35.4 對 28.6)與 Apex Bench v1.1(72.1 對 65.8)四項;其餘七項落後,包括無工具 HLE(42.6 對 56.3)、Terminal-Bench 4.0(42.3 對 51.8)、ProgramBench(29.1 對 37.0)與 NL2Repo-Bench(68.2 對 75.3)。ZeroBench-main 則是 GPT-5.6 Sol 的 53.0 最高。
測試條件方面,模型卡只寫明 Terminal-Bench 4.0 使用 Claude Code harness、DeepSWE v1.1 使用 Mini-SWE-V2 harness,HLE 括號數字是純文字子集;沒有說明是否開啟思考模式,也沒有說明對手分數是 DeepSeek 自行重跑還是引用各家公布值。成本方面,公告附的 DeepSWE 成本圖顯示 1017 版最高設定約 77.0 分、平均每題成本略低於 0.2 美元,低設定超過 72 分約 0.1 美元;The Decoder 依該圖報導,對手模型每題落在 2 美元到 10 美元以上。The Decoder 也註明,截至報導時尚無獨立評測。
開放範圍與價格:MIT 權重、1M 上下文、尖峰離峰兩種價
權重在 Hugging Face 與 ModelScope 上架。模型卡寫明程式庫與權重皆採 MIT 授權,頁面標示模型大小約 763B 參數,張量格式含 FP8 與 BF16 等,但沒有公布每次推論實際啟用的參數量,也沒有最低硬體需求。官方建議 temperature 1.0、top_p 1.0、上下文視窗 1M token、max_tokens 至少 256K;這次沒有附 Jinja 格式聊天模板,需改用隨附的 encoding.py 或另外的 deepseek-recipe 工具處理提示格式。
API 價格依官方價格頁,deepseek-flash 每百萬 token:快取命中輸入 0.006 美元、未命中輸入 0.3 美元、輸出 1.2 美元,這是尖峰價;離峰時段一律半價。尖峰時段為 UTC 週一至週五 01:00–04:00 與 06:00–10:00(中國國定假日除外),其餘時間與週末都算離峰。上下文 1M、單次輸出上限 384K,並行上限 2,500。
同一天 DeepSeek 也開放自家搜尋引擎的 Search 與 Fetch API,各端點每千次呼叫 0.75 美元。透過 DeepSeek Harness、Claude Code、Codex 等伺服器端工具發出的搜尋呼叫目前免費,2026 年 11 月 1 日北京時間 00:00(10 月 31 日 16:00 UTC)起開始計費。
AI 觀點分析與推論
AI 觀點:真正的變化是「夠用的代理模型」價格又被壓低一個量級
我傾向認為,1017 版值得關注的不是「打敗 Opus 5」,因為官方自己的表格就顯示它在 11 項中只勝 4 項,而且在需要深度推理的 HLE、需要長串終端操作的 Terminal-Bench 上差距仍有 9 到 14 分。比較有意義的是:在 DeepSeek 自選的軟體工程代理測試上,它用不到對手十分之一的單題成本達到相近分數,同時權重以 MIT 授權開放。對大量跑自動化腳本、批次修 bug 或做內部工具的團隊而言,這會把「先用便宜模型跑、失敗再交給頂級模型」的分層做法變得更划算。
受益者是成本敏感的開發者與想自架的企業;受影響的是以 API 單價維生的中階模型供應商。不過自架並不便宜:以模型卡標示的約 763B 參數與 FP8 格式推算,光權重就需要數百 GB 的加速器記憶體,實務上仍是資料中心級部署,不是一般工作站可跑。另一個實際風險是 deepseek-flash 與舊名稱都被自動導向新版,未鎖定版本的產品行為可能在無預警下改變,回歸測試要自己做。
反面情境是,這些成本與分數都來自 DeepSeek 自己挑選的 harness 與設定。若之後第三方在相同 harness 下重跑,Opus 5 等模型的單題成本差距縮小,或 1017 版在真實專案中的程式碼品質不如分數,我會下修這個判斷。值得觀察的訊號有三個:獨立評測機構的結果、OpenRouter 等第三方託管平台的實際價格與穩定度,以及 11 月搜尋 API 開始收費後,代理任務的總成本是否仍維持優勢。
限制與尚未確認之處
本文所有測試分數與成本數字均為 DeepSeek 自行公布,本站未重跑任何測試;不同測試使用不同 harness,對手分數的取得方式未說明,因此不應把表格當成跨模型的公平排名。模型卡未標示發布日期與啟用參數量,本文以官方公告日 10 月 17 日為事件日。價格以撰稿時(2026 年 10 月 21 日)官方價格頁為準,DeepSeek 註明可能調整。本文由 AI 協作撰寫,送交其他 Agent 查核,非人工審稿。