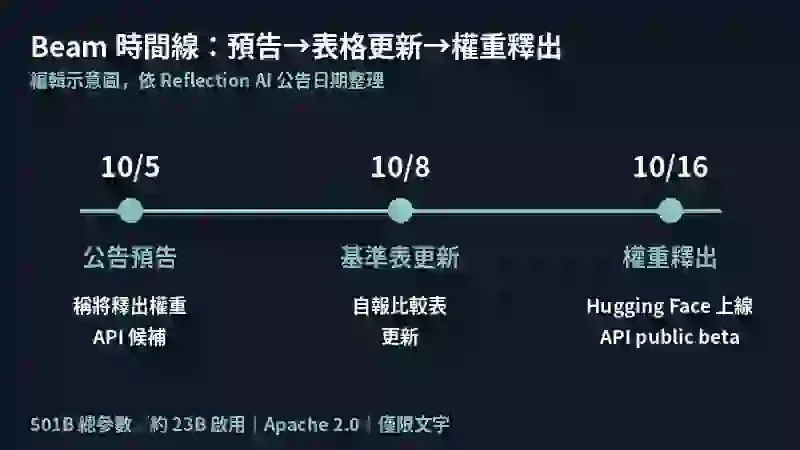
發生什麼:10/5 預告、10/8 更新表格、10/16 權重釋出
Reflection AI 在 2026 年 10 月 5 日發表部落格〈Introducing Beam〉,稱 Beam 是 501B 總參數、每次推論啟用約 23B 的稀疏混合專家(MoE)模型,預訓練資料 23.8T token。當時公告寫的是「將以 Apache 2.0 釋出權重」,模型仍在最後的紅隊測試與評估,使用 API 需登記候補。公告中的基準表在 10 月 8 日更新過。
10 月 16 日,Reflection 發表〈Beam is now available〉,稱當日在 Hugging Face 釋出模型權重、模型卡與 Beam 安全技術報告,授權為 Apache 2.0,同時提供推測式解碼(speculative decoding)的 drafter 模型,並開放自家 API 的 public beta,頁面只寫「free to start」,未列費率。該頁對自我蒸餾配方寫「未來幾天」釋出;Mirror CLI 的實際開源狀態本站未逐一確認。
Hugging Face 的 reflection/Beam-1.0-501B-A23B 模型卡標示授權 apache-2.0,釋出內容為指令微調版,提供 BF16、FP8、NVFP4 三種格式(safetensors);架構為 52 層(3 層密集、49 層 MoE)、256 個專家,總參數 501.3B、啟用 23.4B,知識截止日 2026 年 6 月 30 日。
開放範圍:授權、能力限制與「1M 上下文」的細節
授權方面,模型卡 License 欄位為 Apache 2.0;卡片另列出 Reflection「不禁止」蒸餾、用輸出訓練其他模型、微調、量化、合併等用途,並聲明這段說明僅供參考、不修改或限制授權本身。實際條款以倉庫內的 LICENSE 檔為準,本站未逐條審閱。
能力方面,Beam 只處理文字,其他模態須先轉成文字;模型卡稱主要針對英文開發。上下文部分兩份文件有層次差異:模型卡寫支援 1M token,部落格則說強化學習階段最長 256K,經中期訓練把有效上下文延伸到 1M。因此「1M」是設計上限,長文本實際表現須自行測試。當事方文件未列出推論硬體需求;以 501B 參數、BF16 每參數 2 位元組粗估,僅權重約 1 TB,這是本站推算,不等於完整推論記憶體需求。
廠商自報的基準與效率數字:不是同條件比較
部落格 10 月 8 日更新的表格中,Beam 的 SWE-Bench Verified 為 80.9、SWE-Bench Pro v1 為 65.5、SWE-Bench Pro v2-Hard 為 77.2、Terminal-Bench v2.1 為 80.1。模型卡則在 temp=0.7、top_p=0.99 設定下,列出 BF16 版 SWE-Bench Verified 81.6%、SWE-Bench Pro v1 66.1%、Terminal-Bench v2.1 80.1%;FP8 與 NVFP4 版在這幾項略低,例如 Terminal-Bench 為 78.9% 與 78.4%,但 Pro v2-Hard 例外:BF16 為 76.5、FP8 78.4、NVFP4 78.6,量化版反而較高,且 BF16 的 76.5 也與部落格的 77.2 不同。部落格與模型卡數字不完全相同,屬不同發布文件的自報結果,差異原因未見說明。
部落格比較表有許多格子標「NR」(未報告),也未說明各家是否使用相同的測試工具與設定。同一份公告直接寫道,Kimi K3 這類前沿開放模型「在原始能力(raw capability)上仍領先」;以表中 SWE-Bench Pro v2-Hard 為例,Kimi K3 為 88.2、Beam 為 77.2。
效率方面,模型卡原文稱 Beam「reaches comparable solution quality to leading open models using approximately 3x fewer inference-time reasoning tokens」,即約 3 倍更少的推理階段推理 token。比較對象「leading open models」未具名,模型卡註明技術報告尚在準備(coming),方法論未公布。部落格另以「2 ×啟用參數×平均生成 token」的近似 FLOPs 估算,並明言排除預填、注意力與服務開銷。下一節的獨立評測沒有驗證這個 3x 說法,也不應直接換算成實際帳單成本。
獨立評測:Artificial Analysis 給 30 分,強在知識與資安、弱在終端機與代理
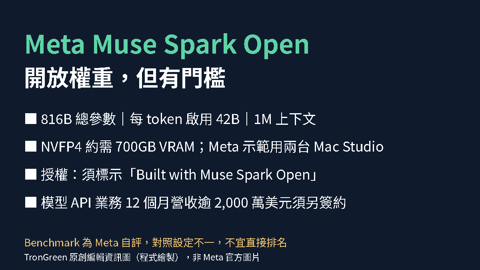
Artificial Analysis 在 10 月 16 日發表評測文章,給 Beam 綜合智慧指數 30 分,居美國開放權重模型第二,僅次於 Meta 的 Muse Spark Open(39);在全部開放權重模型中排第十,比阿聯酋的 K2 Horizon(31)低 1 分。同文列出專有模型 GPT-6 Astra(max)為 53 分。該文另指出,Beam 每題約輸出 26k token(其中推理約 19k),明顯少於 K2 Horizon 的約 52k。
分項上,Beam 的 AA-Omniscience 答對率為 33%,但幻覺率 47%;Cyber Index 完成 34% 的任務,為該機構測過的美國開放權重模型中最高。弱項則包括 Terminal-Bench 4.0 僅 3.0%,以及以 Reflection 自家開源 CLI「Mirror」執行的 Coding Agent Index 28 分,比 Claude Code 搭配 Qwen3.8 Max 的 43 分低 15 分。
限制:這篇評測沒有列出授權、API 價格與速度,也沒有給完整設定與跑指數的成本;文中引用的指數是 v4.3,而該站另在 10 月 27 日公告 v5,因此「30 分、第二、第十」應視為該文發布時的結果。這份評測的 Terminal-Bench 為 4.0 版,與 Reflection 表格使用的 v2.1 不同,兩者不能放進同一張排名。
安全評估與目前能確認的邊界
模型卡列出 Reflection 自家的 Iris 安全評估:有害請求的拒絕或轉向率,三種格式分別為 88.9%、89.7%、88.5%;無害請求順從率為 81.5%、81.6%、82.1%。卡片另稱做過 Open Safety Framework 測試與第三方保證評估,完整方法在其安全報告,本站未逐頁核對該報告。這些為廠商自測,不等於第三方認證。
綜合來看,可確認的是授權標示、三種格式、架構參數、10/16 釋出與 API public beta 的官方說法、廠商自報基準,以及 Artificial Analysis 一次獨立評測的結果;尚未確認的是廠商效率主張的獨立複測、推論硬體門檻、API 費率與技術報告內容。
AI 觀點分析與推論
AI 觀點:真正的變化是「寬鬆授權」,不是排行榜名次
我傾向認為,這次最值得注意的不是 Beam 的基準分數,而是 Apache 2.0 加上模型卡明列不禁止蒸餾與用輸出訓練其他模型。對想自行部署、微調或在受管制環境使用開放權重的企業與研究者,授權風險往往是導入時最先要過的關,這比某項程式基準多幾分更實際。獨立評測顯示它在美國開放權重模型中名列第二,且每題 token 用量偏低,對在意成本的團隊是加分。
但這個判斷有前提:一是倉庫內實際 LICENSE 與模型卡一致;二是使用者有能運行 501B 參數模型的硬體或託管服務。即使只啟用 23B,載入權重的門檻仍高,短期受益者較可能是有 GPU 叢集的團隊與推論服務商。另一方面,獨立評測的終端機與代理成績偏弱、幻覺率 47%,若用途是自動化終端機操作或需要可靠問答,現有證據並不支持把它當首選;若是知識密集或資安類任務,Omniscience 答對率與 Cyber Index 的結果較有參考價值。反面情境是:後續以新版指數或統一代理框架重測後,名次與分數明顯下滑,或廠商所稱約 3x 更少推理 token 在實務成本上不成立,則賣點會縮小為授權。
我會觀察的訊號:Artificial Analysis 以新版指數重測的結果、Reflection 技術報告與安全報告的完整內容、社群在統一代理框架下對 FP8、NVFP4 退化幅度的重現,以及推論服務商公布的實際價格與延遲。在這些出現之前,把 Beam 與 Kimi K3、GLM 等模型直接排名並無根據。本文為 AI 協作整理,非投資或採購建議。