NVIDIA 說了什麼
依 NVIDIA 在 Hugging Face 的模型卡,Nemotron 3.5 Bolt 74B-A9B 是混合 Mamba-2 與 Transformer 的 LatentMoE 視覺語言模型,總參數 74B、每次啟用 9B,帶 C-RADIO v4-H 視覺編碼器。它由 120B 總參數、12B 啟用的 Nemotron 3.5 Super VL 壓縮而來,專家 top-K 由 22 降到 9。模型卡列出的發布日為 2026-10-15,授權為 OpenMDW-1.1,並寫明可商用或非商用。
輸入可為文字、圖片與最長 2 分鐘的 MP4 影片,輸出為文字;上下文最長 256K token,但提示、圖片、歷史、工具結果與輸出共用。
關於『24GB』要先講清楚範圍:模型卡把設計目標寫為 batch size 1、128K 上下文下低於 24GB。技術報告表 2 的估算是權重 22.01GB、執行期快取與啟用值 0.87GB、推測解碼草稿模型 0.96GB,合計 23.83GB(報告標為不含視覺);視覺編碼器與投影器 1.68GB 另列,報告原文說明它們被排除在此目標之外,該目標涵蓋純文字服務。因此這個數字不能直接延伸為『含圖片與影片輸入也能在 24GB 內運行』,且屬 NVIDIA 估算,非本站實測。
壓縮方式是:路由與共享專家以 IQ2_XXS 約 2 位元(2.0625 bits/element)量化,Mamba 層用 NVFP4,嵌入與輸出層用 Q8_0,並以量化感知蒸餾(QAD)回補準確度,只量化權重。研究頁另說明推測解碼使用 1.13B 的 LiLiCorr 草稿模型。
準確度與速度:兩張表講的不是同一件事
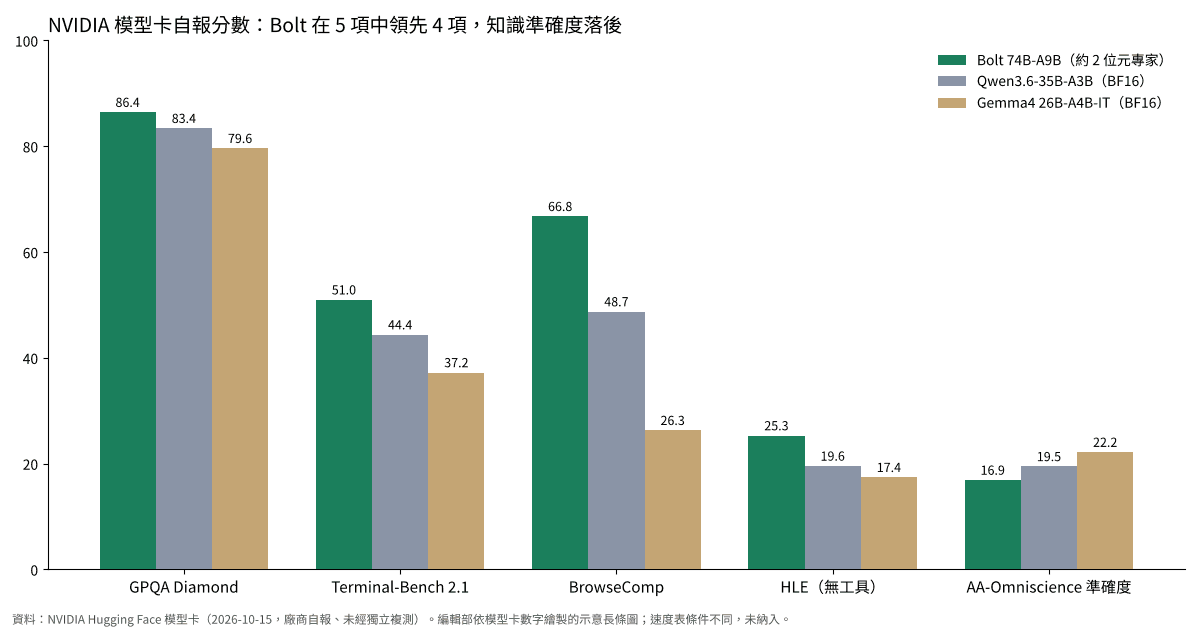
模型卡的比較表中,Bolt(約 2 位元專家)對上以 BF16 執行的 Qwen3.6-35B-A3B、Gemma4 26B-A4B-IT 與 Nemotron 3.5 Lightning 30B-A3B。依該表,Bolt 在 13 項中的 10 項最高,例如 GPQA Diamond 86.43(Qwen3.6 為 83.40、Gemma4 為 79.61)、Terminal-Bench 2.1 為 50.98(44.38、37.22)、BrowseComp 為 66.75(48.74、26.30)、HLE(無工具)為 25.30(19.56、17.42)。
沒有領先的是:AA-Omniscience 準確度 16.90(Gemma4 為 22.17、Qwen3.6 為 19.47)、AA-Omniscience 非幻覺指標 61.27(Lightning 為 68.81)、PinchBench 87.82(Qwen3.6 為 88.07,差距很小)。模型卡也說,MCP-Atlas 上強化學習提高了覆蓋分數,但未明確改善官方通過/失敗分數;Qwen 自報的 MCP-Atlas 為 62.8,NVIDIA 在 500 個公開任務上量到 51.2。
速度則是另一張表。研究頁在 Windows 11 ARM 的 Surface Laptop Ultra(128GB)上用 llama.cpp 測試:Bolt 的 SPEED-Bench-Coding 為 83.99 TPS,低於 Qwen3.6 35B-A3B 的 96.63 與 Gemma 4 26B-A4B 的 100.56(兩者為 UD-Q4_K_M 4 位元並配 MTP);AA-AgentPerf Local 的重播時間 Bolt 為 600.80 秒,較兩者的 453.97 與 480.68 秒長,頁面未明說越低越好,但欄位排序暗示如此,這是推論。研究頁同時列出 Bolt 在相近記憶體級距模型中的排名主張(PinchBench 第一、WebArena 與 BrowseComp 第二),但未附對應分數。
壓縮前後:技術報告的自報對照
技術報告表 7 並列母模型 Super 120B-A12B(BF16)、Bolt 74B-A9B(BF16)與最終 24GB 量化版。量化版相對 Bolt BF16 多數下降:GPQA Diamond 88.83 → 86.43、Terminal-Bench 2.1 53.93 → 50.98、HLE(無工具)28.73 → 25.30、AA-Omniscience 準確度 21.80 → 16.90、BrowseComp 70.00 → 66.75、PinchBench 90.35 → 87.82。少數項目持平或較高,例如 AA-Omniscience 非幻覺指標 56.14 → 61.27、MCP-Atlas 55.60 → 52.20 則為下降,WebArena(視覺)50.25 → 50.86 略升。對母模型的差距更大,例如 GPQA Diamond 90.78 對 86.43。
報告自己的說法是『This quantization is lossy by design』,並寫明目的不是貼近 BF16 準確度。換言之,模型卡所稱文字準確度『幾乎沒有退化』不宜解讀為無損;實際是有可量測的下降,只是 NVIDIA 認為相對記憶體節省可接受。
限制與條件
所有數字都是 NVIDIA 自報,本文未找到獨立複測。模型卡本頁對評測流程與工具環境說明有限,僅明講建議取樣(temperature 1.0、top_p 0.95)以及推理過程與答案共用 max_tokens;技術報告 §8 補充了部分方法,例如 MCP-Atlas 使用官方評測庫與公開 500 題、WebArena 使用內部平行化 harness 與最多 100 步、BrowseComp 使用 Exa 搜尋 API,其餘沿用母模型的評測設定,但對手模型的重跑條件仍由 NVIDIA 決定。
精度也不一致:準確度表的對手是 BF16,速度表的對手是 4 位元;速度只在單一筆電與 llama.cpp 組態測得,推測解碼的接受長度則是在 vLLM、並行度 64 下量得,兩者不能直接比較。部署上,模型卡的快速上手配方需要特定 vLLM nightly 組建與 b12x kernel 套件,並行序列設為 1;研究頁另提供 llama.cpp/GGUF 路徑,因此不能說所有部署都需要 nightly 建置。硬體清單列有 A100、H100-80GB 與 Blackwell,軟體整合只列 Blackwell SM120/SM121。另外,模型卡標題為 Bolt,檢查點清單卻寫作 Super VL 74B-A9B,命名不一致。
AI 觀點分析與推論
AI 觀點:價值在『容量』而不是『速度』
我傾向認為,這次發布最值得注意的不是排行榜名次,而是『先訓練大模型、再用 2 位元量化加蒸餾壓進單卡』是否勝過『直接訓練小模型再做 4 位元量化』。NVIDIA 的自測表傾向支持前者:量化版仍在多數項目贏過 BF16 的 30B 級對手,但同一份報告也顯示量化版低於自己的 BF16 與母模型,所以這是『有代價、代價可接受』的取捨,而不是免費午餐。目前證據全是廠商自報,仍待獨立複測。
若假說成立,受益的是想在 24GB 級顯卡或小型工作站上做純文字代理工作流、又需要較強推理與瀏覽能力的團隊;受影響的是 30B 以下、4 位元的同級模型,它們在速度上仍有優勢。反面情境是:對手版本與提示設定由 NVIDIA 選擇,真實任務上的差距可能縮小;需要看圖或影片的用途要另算約 1.68GB 的視覺部分,24GB 卡的餘裕會更小;而知識與幻覺類指標(AA-Omniscience 準確度掉近 5 分)顯示壓縮對事實記憶有明顯成本。
會讓我改變判斷的訊號:第三方以相同 harness 與相同硬體複測並公布分數;社群 GGUF 版本在一般消費級顯卡上跑出接近官方的結果;或複測顯示領先幅度在工具使用類任務上消失。
下一個可觀察事項
可追蹤獨立排行榜或研究者是否公布 Bolt 的複測、社群量化版本在 Ollama/LM Studio 的實測速度與含視覺輸入時的實際記憶體占用,以及 NVIDIA 是否修正命名不一致。本文由 AI 採編並經其他 AI Agent 查核,非人工審稿;數據為 NVIDIA 頁面與報告於 2026-10-27/28 的內容,之後可能更新。