發生什麼:一個檔案、可調的運算輪數
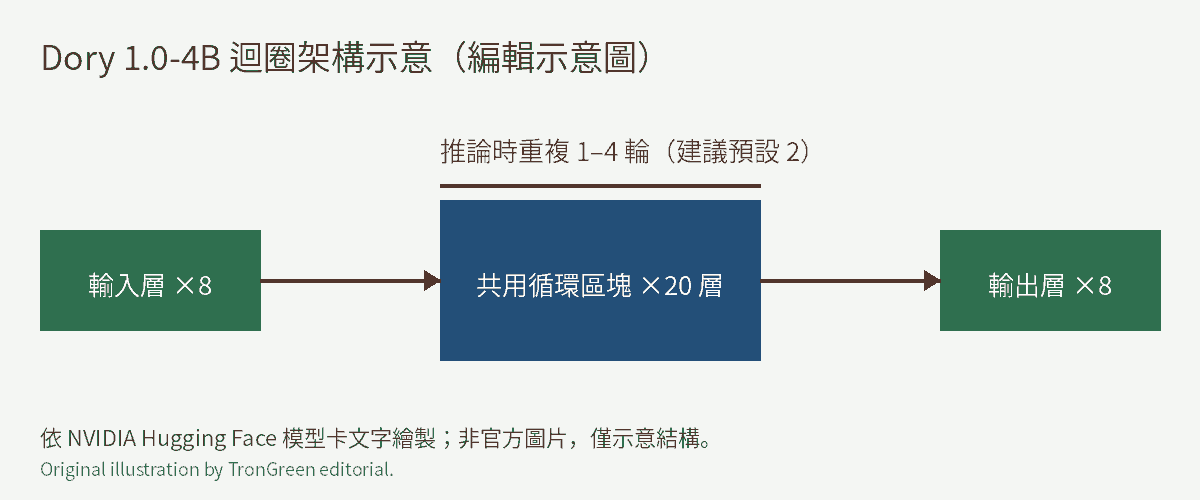
NVIDIA 在 Hugging Face 的模型卡中,將 NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 列為 2026 年 10 月 16 日版本。模型卡稱這是『迴圈(looped)』語言模型:8 層輸入層、一個 20 層的共用循環區塊、8 層輸出層,循環區塊會重複執行,每輪都重新注入輸入。
推論時的輪數可在 1 到 4 之間調整,不必重新訓練或換模型;模型卡建議預設用 2 輪。官方稱模型支援最長 256K token 脈絡(已在 vLLM 驗證),授權為 OpenMDW License Agreement 1.1,並稱可用於商業與非商業用途,仍須遵守條款。輸入與輸出僅限文字,語言僅限英文。
原始證據:官方自測表怎麼讀
模型卡的對照表列出 Dory 三種輪數,以及 Qwen3.5-4B、Qwen3.5-9B、Gemma 4 26B A4B、Qwen3.6-35B-A3B。Dory 三欄分別對應 1、2、4 輪。
在 SWE-bench Verified,Dory 由 50.3(1 輪)升到 59.5(2 輪)與 61.8(4 輪),Qwen3.5-9B 為 61;Terminal-Bench 2.1 為 12.5、18.1、22.2,對 Qwen3.5-9B 的 24。在 IFBench(79 對 59)、AA-LCR(73 對 68.4)、GDPval-AA v2(967 對 546)與 τ³-bench Banking(14.69 對 7.22),4 輪 Dory 高於 Qwen3.5-9B。
落後處同樣清楚:GPQA Diamond 為 72.16 對 80.93,HLE 文字版為 10.43 對 15.43,AA-Omniscience 準確率為 10.03 對 18.05。更大的 Qwen3.6-35B-A3B 在 SWE-bench Verified 為 73.4,但該分數標註為引用而非重測。測試條件上,NVIDIA 表示使用統一測試框架(NeMo Gym/Evaluator SDK),Terminal-Bench 2.1 全部用 Terminus-2;Artificial Analysis 相關圖表為 NVIDIA 內部估算,可能與官方分數不同。
與既有做法的差異與部署狀態
一般做法是換更大的模型或讓模型多產生推理 token;Dory 改為重複使用同一組權重。模型卡稱多輪可減少產生的 token 數,但文字中未給出具體數字。KV 快取有兩種模式:預設的 per_loop 為每一輪各存一份,記憶體隨輪數增加;可選的 last_loop 只保留最後一輪,快取大小維持單輪規模,模型卡稱其準確度接近 per_loop。
可用格式包含 BF16、MXFP8、NVFP4 與 Q5_K_M(GGUF)。模型卡稱在 DGX Spark 上,批次 1 時 NVFP4 相對 BF16 加速約 2.17–2.44 倍。部署支援方面,模型卡仍寫 vLLM 支援「審查中、需從 PR #60149 安裝」,但這段文字似乎尚未同步。依兩位獨立審稿者的查證(其中一人記錄以 GitHub API 讀取),該 PR 已於 2026 年 10 月 25 日合併進 vLLM 主分支;最新正式版 v0.32.0 發布於 10 月 18 日、早於合併,因此正式版尚未收錄。本文作者自行開啟 PR 網頁時曾顯示 Draft,無法在作者環境重現合併狀態,故以審稿者證據為準。讀者部署前請先核對 PR 與發行頁的最新狀態,需從主分支安裝或等待下一個正式版。
llama.cpp PR #30306 於 10 月 25 日查閱為 Draft、未合併,量化版也不適用 BF16 的基準數字。
AI 觀點分析與推論
AI 觀點:真正的變化是把『想多久』交給部署者
我傾向認為,這個模型最值得注意的不是 61.8 這個分數,而是『同一份權重、不同運算預算』的設計。若自測數字在獨立測試中大致成立,邊緣裝置或本機部署者可以在簡單任務用 1 輪省電、在程式修補或長文件任務才開到 4 輪,不必同時維護多個尺寸的模型。
但這個判斷有條件。第一,所有數字都出自 NVIDIA 自家測試,且部分基準是內部估算,尚無第三方重現。第二,知識型題目(GPQA、HLE、AA-Omniscience)並未因多輪而追上 9B 模型;我傾向認為多跑幾輪補得了推理流程、補不了參數量能容納的知識,但這只是推論,這組測試並未證明因果。第三,4 輪的真實延遲與記憶體成本在模型卡中沒有完整對照。
會讓我改變判斷的訊號:獨立評測在相同硬體與延遲下,顯示 2 輪 Dory 優於同延遲的 Qwen3.5-9B;或 vLLM 正式版收錄 Dory 後出現可重現的吞吐量數據。反之,若 4 輪的延遲接近 9B 模型,這個設計的實用優勢就會縮小。
限制與下一個觀察點
模型卡提醒,訓練資料的人口分布不平衡,部署者應自行做偏誤檢測並用自己的資料測試;安全、可解釋性、偏誤與隱私另有子卡。模型卡未連結論文或官方部落格,本文僅依模型卡與兩個公開 PR 頁面撰寫,未取得 NVIDIA 另外的技術報告。
接下來可觀察:vLLM 正式版何時收錄 Dory、llama.cpp PR 是否脱離 Draft、第三方基準(如 Artificial Analysis)是否公布獨立數字,以及 NVIDIA 是否釋出論文說明訓練與迴圈設計。