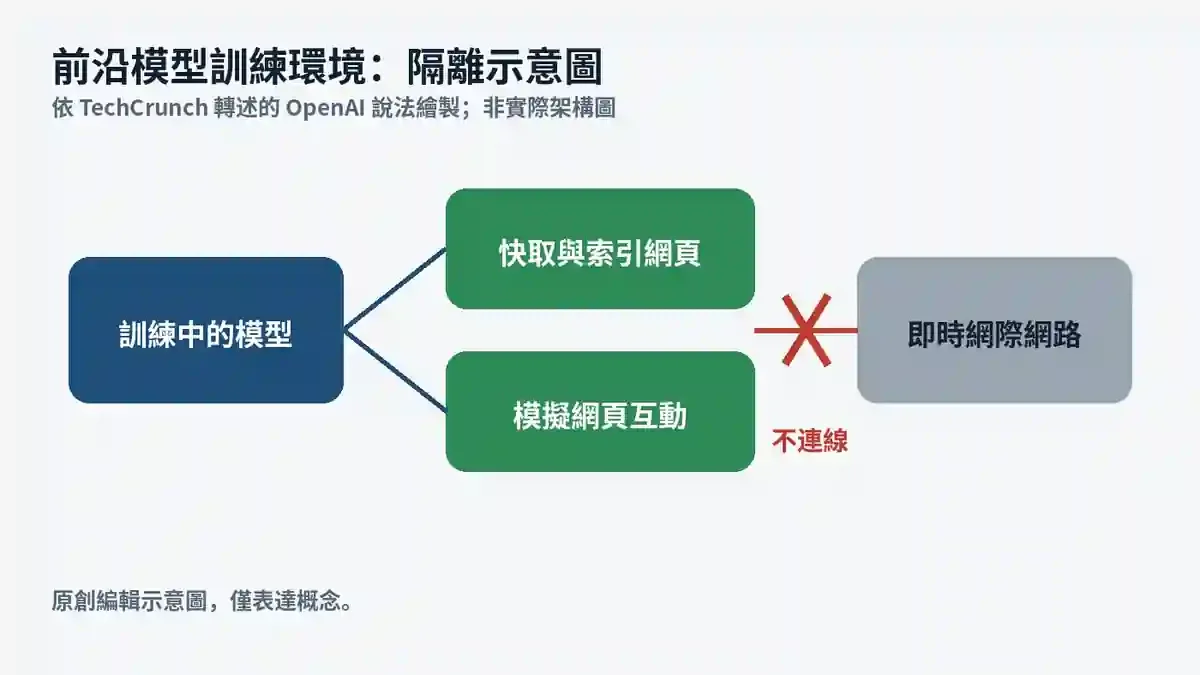
報導說了什麼
TechCrunch 報導,OpenAI 在 10 月 23 日表示,今後前沿模型的訓練將不接觸即時網路,改用自行建立的大量索引與快取網頁內容,讓模型在其中互動。報導引述 OpenAI 的說法:依目前對齊研究、監控系統與網路安全的狀態,負責任的做法是讓前沿模型訓練「完全沒有網路存取」,且公司必須始終能阻止前沿模型取得未經授權、任意的即時網路存取。
TechCrunch 稱該文章對應 OpenAI 部落格「Securing our frontier model training environment」。本站撰稿時嘗試開啟該頁面失敗,因此上述內容皆以 TechCrunch 轉述為準,未能與 OpenAI 原文逐句核對;報導中的其他細節,例如 9 月 20 日的事件與 Anthropic 的相關限制,同樣是 TechCrunch 的說法,本站未獨立驗證。
報導範圍是「前沿模型訓練」。就 TechCrunch 所述,這項政策並未談到已上線模型的推論或使用者端的瀏覽功能,讀者不宜把它理解成模型產品不能上網。
背景:8 月的暫停與監控
OpenAI 在 8 月 18 日的文章中說明,因 OpenAI 與 Hugging Face 之間的安全事件,以及即將推出的 Astra 模型可能達到其準備框架的「關鍵」網路安全能力門檻,公司刻意放慢擴張。文中提到:能執行程式碼或連網的研究叢集推論曾暫停;最大規模的前沿強化學習訓練仍擱置;對使用工具的強化學習訓練與評估要求多階段監控,目標是在疑慮出現後 30 分鐘內發出警示,額外監控約增加 20% 的受監控推論算力。
這份文章談的是加強沙箱隔離、網路隔離與監控,並未宣布完全斷網。10 月的說法若屬實,代表從「限制網路」進一步走到「訓練不連即時網路」。這是本站的比較,並非 OpenAI 原文用語。
AI 觀點分析與推論
AI 觀點:真正的代價在研究流程,而不是網頁品質
我傾向認為,這項承諾的重點是把『能否阻止模型連到外部』變成可驗證的工程條件,而不是追求更乾淨的訓練資料。快取網頁讓實驗可重現,也讓外洩路徑縮小;代價是要持續維護一份夠大、夠新、夠像真實網路的模擬環境。TechCrunch 引述前 OpenAI 研究員 Steven Adler 的看法:這會讓研究團隊更依賴資料中心內作業,且單一公司獨自承擔未必划算。這是報導中的批評,我認為它點出了真正的成本。
若模擬網頁與真實網路的差距很小,這會是一個可被同業複製的安全基準;若差距明顯,模型可能在訓練時學到過度順從的網頁行為,部署到真實網路時表現不同。目前沒有公開的對照數據,所以我不會把它讀成能力或安全已被證明的結論。
會改變我判斷的訊號有三個:OpenAI 原文是否明確定義『即時網路』與例外情況、後續技術報告是否公布模擬環境與真實網路的差異,以及其他實驗室是否跟進同樣的隔離標準。
限制與下一步
目前缺少的資訊包括:政策何時生效、是否涵蓋所有前沿訓練階段、第三方如何驗證、以及模擬網頁對模型能力的影響。OpenAI 8 月曾表示將公布技術報告並發表監控系統的文章;本站尚未確認這些文件是否已出現。
在取得 OpenAI 10 月原文前,建議把這則消息視為『公司宣示的訓練環境政策』,而非已完成的第三方驗證。