發生什麼事:一批 AI 論文中最受關注的一篇
OpenAI 在 2026 年 10 月 6 日發布〈Sharing AI progress in mathematics〉,宣布公開由一個未具名的「內部前沿模型」產出的大量數學結果,論文與證明檔放在 GitHub 的 openai/math 儲存庫。官方文章說,平均每個結果使用的運算量約相當於 ChatGPT Pro 思考三小時;發布前曾向普林斯頓高等研究院(IAS)的數學與人工智慧顧問小組徵詢做法。產出這些結果的模型目前沒有開放,OpenAI 只表示正在研究如何「負責任地釋出」。
本站 10 月 20 日存取該儲存庫時,README 寫的是「719 篇手稿、分成 372 個系列」,約 42% 的主要結果有 Lean 形式化證明,並註明「部分未形式化的結果可能有問題」。Quanta Magazine 的報導則在不同段落分別寫到 377 個結果與 722 篇論文;儲存庫的數字可能隨更新變動,讀者應以 OpenAI 儲存庫當下標示為準。
在這批結果中,最受數學界注意的是一篇題為〈The Quasi-Riemann Hypothesis〉的論文。Quanta Magazine 於 10 月 19 日刊出長篇報導,訪問多位數論學者對這項證明的看法。
「準黎曼猜想」證了什麼、沒證什麼
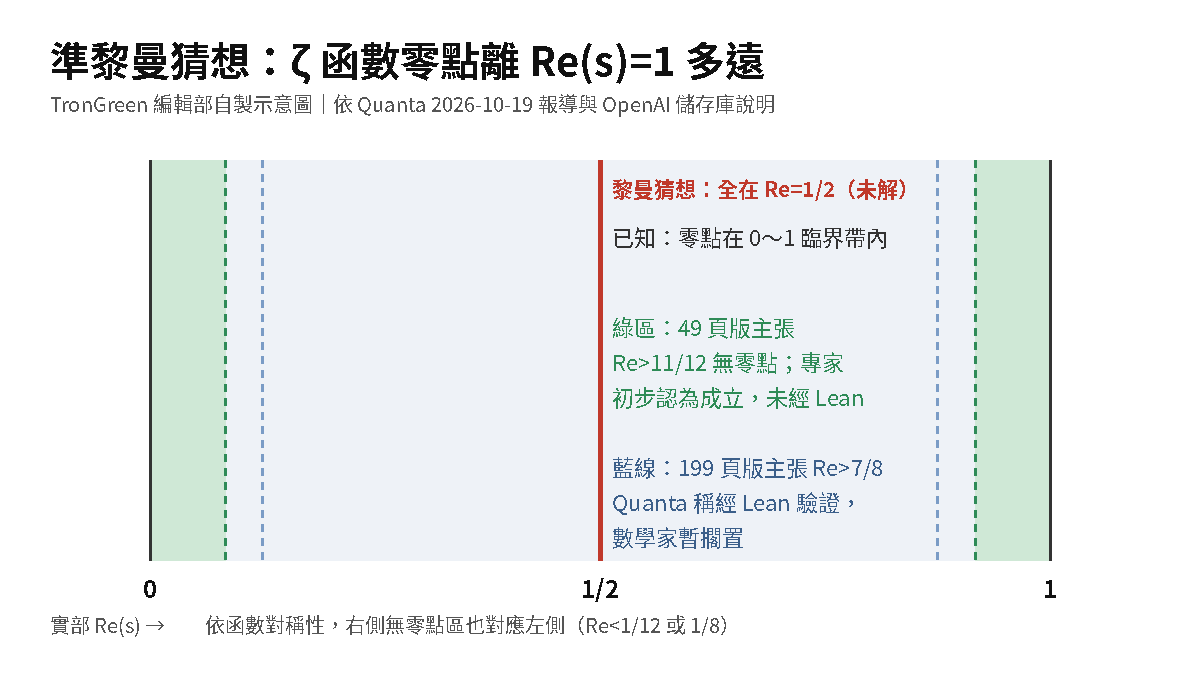
黎曼猜想主張,ζ 函數所有非平凡零點的實部都等於 1/2。目前已知的是這些零點都落在實部 0 到 1 之間的「臨界帶」。依 Quanta 的說明,「準黎曼猜想」是較弱的版本:只要證明所有非平凡零點都落在比 0 到 1 更窄的一條固定寬度帶狀區域內即可。帶狀區域越窄,能推出的質數分布結論就越強。
依 Quanta 報導,OpenAI 先後放出兩個版本:9 月 30 日版約 199 頁,主張零點的實部都在 1/8 到 7/8 之間;10 月 5 日版約 49 頁,主張的範圍是 1/12 到 11/12。OpenAI 儲存庫 README 也提到一份「Re(s) > 11/12 零點不存在區域」的寫作稿。換句話說,較短的版本結論較弱、但較易讀,數學家目前主要檢查的是這一版。
受訪的紐約大學數學家 Maksym Radziwiłł 說,黎曼猜想的大多數推論其實已可由準黎曼猜想推出;但普林斯頓的 Will Sawin 也說,人們離完整黎曼猜想仍和以前一樣遠。黎曼猜想本身沒有被證明。
驗證到哪一步:專家初步認可,但還不是期刊定論
Quanta 寫道,受訪專家「大致同意結果正確」,Stanford 的 Jared Duker Lichtman 稱這是「目前為止最重要的 AI 數學成果,而且差距不小」。另有數位數學家撰寫 7 到 13 頁的重寫稿,目前私下流傳、尚未發表;Radziwiłł 說他能用半頁勾勒出論證。證明沒有引入全新概念,而是把既有工具組合起來,其中包含 Radziwiłł 與喬治亞理工 Alexander Dunn 在 2021 年證明的一個公式,以及 Dunn 研究多年的 metaplectic forms。
限制同樣明確。依 Quanta,經 Lean 形式化驗證的是 199 頁、7/8 的版本,但數學家把它放在一旁;大家檢查的 49 頁、11/12 版本則尚未形式化驗證。11/12 版本是 10 月 6 日那批論文中唯一經人編輯的一篇,OpenAI README 也證實這份寫作稿「經人工編輯以提升可讀性」,但 OpenAI 沒有說明編輯者是誰。Radziwiłł 形容論文寫得「很糟」,任何數學期刊都會退稿;普林斯頓的 Peter Sarnak 則說,在人類檢查並理解所有細節之前,他不會把它當成定理。
需要附帶說明的是,Quanta Magazine 由 Simons Foundation 支持;OpenAI 在 10 月 15 日的更新中宣布向 Simons Foundation 的新計畫捐助 500 萬美元。本站未發現這影響報導內容,但讀者可自行納入判斷。
AI 觀點分析與推論
AI 觀點:真正的變化是「誰負責檢查」
我傾向認為,這件事最重要的訊號不是 AI 會不會解黎曼猜想,而是數學驗證的工作量開始倒過來分配。過去一篇重要證明由少數作者寫成、再由審稿人檢查;這次是一個模型一次丟出七百多篇手稿,最受矚目的一篇寫作品質差到專家說會被退稿,真正讓結果可信的,是 Radziwiłł、Dunn 這些本來就在這個方向工作的人花時間重寫與核對。受益最大的是能立刻判斷「哪篇值得看」的頂尖專家;壓力最大的是期刊、審稿人,以及沒有能力自行檢查、只能讀新聞標題的讀者。
第二個判斷是,形式化驗證的價值會被重新定價。這次被 Lean 驗證的版本反而不是數學家關注的版本,說明「有 Lean 證明」和「數學社群接受」仍是兩件事;但若 OpenAI 補上 11/12 版的形式化證明,或專家重寫稿正式發表,這項結果的可信度就會從「專家初步同意」升到接近定論。反過來,若有人在 11/12 版找到無法修補的漏洞,那麼目前約四成的形式化比例,就會成為判讀其他七百多篇論文時更重要的篩選條件。
我也不認為讀者該把這解讀成「AI 已經比數學家強」。依專家說法,證明是既有想法的出色組合,而且依賴人類近年才證出的關鍵公式;模型的貢獻更像是在人類沒想到要試的方向上大膽嘗試。模型未開放、無法重現,是目前評估這類宣稱時最大的缺口。
限制與接下來可觀察的事
本文的專家評價與兩個版本的頁數、界限、Lean 驗證狀態,主要依據 Quanta Magazine 報導;本站撰稿工具無法開啟 GitHub 上該篇論文的資料夾,只讀到儲存庫 README 中關於 11/12 寫作稿經人工編輯的說明,未獨立檢查證明內容。OpenAI 的官方文章沒有點名準黎曼猜想。本文不是數學審查,也不代表任何 AI 模型的公開能力。
原始發布日為 2026 年 10 月 6 日,Quanta 報導日為 10 月 19 日,本站整理日為 10 月 20 日。
- 11/12 版本是否補上 Lean 形式化證明,或專家重寫稿是否正式發表、投稿。
- 是否有人指出無法修補的錯誤,以及 OpenAI 依儲存庫「修訂保留舊版」原則如何更正。
- 產出結果的模型是否、以何種形式與限制對外開放。
- 其餘數百篇手稿中,有多少被獨立專家確認或推翻。