發生什麼:記憶框架、寫入模型與跨工具 App 一起開源
騰訊混元的 Hy-Memory 官方頁面把開源日期標為 2026 年 10 月 16 日,內容分三層:負責讀寫記憶的模型 Hy-Memory-30B-A3B、負責儲存與召回的 Hy-Memory 框架(以 Python SDK 提供),以及應用層 MemHub。GitHub 中文 README 寫明 SDK 版本為 hy-memory 2.0.3,可用 pip 安裝,程式碼採 Apache-2.0;Hugging Face 模型卡則把模型授權標為 apache-2.0,權重為 BF16/F32。
SDK 分三種情境:聊天記憶、工作記憶(工作階段事實與可重用經驗)與程式碼記憶(在工作記憶之上加 diff 版本鏈)。README 也寫明,SDK 本身需要接一個 OpenAI API 相容的大型語言模型與嵌入服務;工作與程式碼記憶的寫入需要工具呼叫紀錄,且只在 pro 或 ultra 模式可用。
MemHub 是 CLI 與 Mac App,官方頁面列出可匯入或同步 10 種工具的歷史紀錄,包括 Cursor、Codex、Claude Code、OpenCode、Qwen Code、DeepSeek Harness 等,透過 SDK 轉成「本地記憶」。官方頁面未說明定價,也沒有進一步的隱私承諾說明。
寫入模型怎麼測:20% 子樣本、四個框架只換「寫入者」
Hy-Memory-30B-A3B 是混合專家模型,模型卡寫總參數 30B、啟用約 3B。它不負責回答問題,而是取代 Mem0、MemOS、Hy-Memory 這類記憶框架中「決定要寫進什麼、如何處理衝突」的通用大型語言模型。arXiv 技術報告(10 月 15 日 v1)說明訓練分兩階段:先以 Memory On-Policy Distillation 學會各框架的寫入格式,再以強化學習針對後續「答不答得出來」優化,並加入過度儲存的懲罰。
評測方式是:每個基準只取固定 20% 子樣本,在 Mem0、Hy-Memory、MemOS 與訓練時未使用的 EverMemOS 四個框架中,只更換寫入模型,其餘固定;每個框架計算六項指標(LoCoMo、LongMemEval、PersonaMem-v2、旅遊規劃、購物、程式碼記憶 CMB)的等權平均。模型卡稱評審模型在比較中固定,但沒有寫出是哪一個模型。
數字怎麼讀:平均微勝,單項有輸有贏
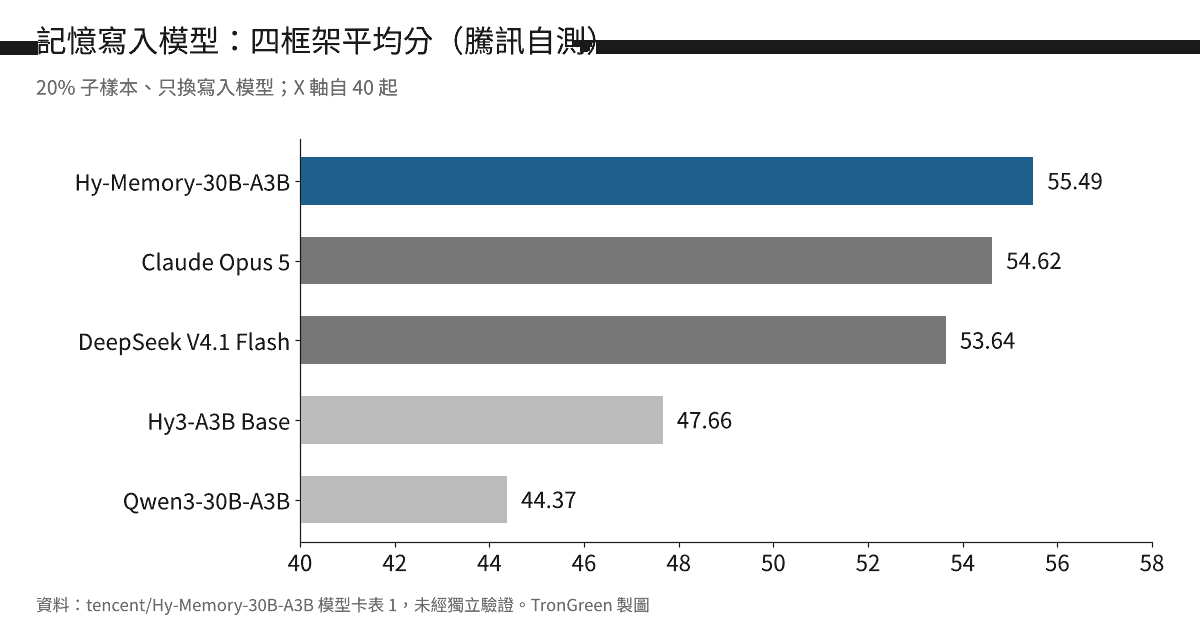
依模型卡表 1,四個框架宏平均:Hy-Memory-30B-A3B 55.49、Claude Opus 5 54.62、DeepSeek V4.1 Flash 53.64、Qwen3.6-35B-A3B 50.37、Qwen3-30B-A3B 44.37。逐框架看,它對 Opus 5 的領先在 Mem0 為 0.59 分(54.02 對 53.43)、Hy-Memory 為 0.02 分(60.55 對 60.53)、MemOS 為 0.01 分(50.51 對 50.50),只有訓練未見過的 EverMemOS 拉開 2.85 分(56.89 對 54.04)。
單項差異更大。以 Mem0 框架為例,LoCoMo 為 59.54 對 Opus 5 的 69.47,落後近 10 分;LongMemEval 73.00 對 66.00、旅遊規劃 54.51 對 42.98 則領先;程式碼記憶 CMB 67.13 對 70.74 落後。換言之,宏平均微勝來自不同指標互相抵銷,不是每項都贏。
相對清楚的是同尺寸比較:同為約 3B 啟用參數的 Qwen3-30B-A3B 宏平均 44.37、Hy3-A3B Base 為 47.66,專門訓練後的 Hy-Memory-30B-A3B 高出約 8 至 11 分。
另一組「72.6%」是框架成績,測試條件不同
官方頁面另列框架層級成績:聊天記憶 LoCoMo 準確率 72.6%,條件是 1,527 題非對抗題、以 DeepSeek V4.1 Flash 當記憶模型、GPT-5.6-sol 負責回答與評分,比較對象為 Mem0、MemOS、EverOS 等開源框架;工作記憶 MemoryArena 平均 55.31%;程式碼記憶 CodeMemoryBench 問答 64.2%、任務解決 35.6%,SWE-ContextBench 解決率 28.3%。
這組數字衡量的是「Hy-Memory 框架搭配 DeepSeek」而非 30B 寫入模型,題目範圍也是完整題集而非 20% 子樣本,因此不能和上一節寫入模型的 59.54 或 73.28 等 LoCoMo 數字放在一起排名。以上所有成績都由騰訊自行公布,本文撰寫時未見第三方重現。
AI 觀點分析與推論
AI 觀點:值得注意的是「記憶寫入可以外包給小模型」,不是贏了 Opus 5
我傾向認為,這次發布最有意義的不是宏平均多出的 0.87 分,而是它示範了一種分工:代理的長期記憶由一個啟用約 3B 參數、可自架的專用模型負責寫入,回答問題時才用大模型。若這個做法在獨立評測中站得住腳,受益的是需要長時間運行的程式碼代理與企業內部助理——記憶寫入是高頻、背景執行的工作,換成可自架的小模型,成本與資料留存位置都更好掌控。
但「勝過 Opus 5」這個說法目前證據不足。兩個框架的差距只有 0.01 與 0.02 分,評測只用 20% 子樣本、評審模型未公開,這樣的差距很可能落在抽樣與評審變異之內;而 Mem0 上 LoCoMo 落後近 10 分,代表在純對話記憶回憶上,大模型仍有明顯優勢。我會把它讀成「同尺寸開源模型的大幅進步,在部分框架上接近頂級閉源模型」。
MemHub 則是另一個值得關注的方向:把 Cursor、Claude Code、Codex 等工具的紀錄集中成一份個人記憶,方便,但也把散落各處的程式碼與對話集中到同一處。若騰訊後續公開資料儲存位置、加密與刪除機制的細節,這會是開發者真的會用的工具;若沒有,企業使用者應先在隔離環境試用。會讓我改變判斷的訊號:第三方在完整題集上重現結果並公開評審模型;或社群在 Mem0 等主流框架實測後,回報寫入品質在長時間使用中退化。
限制與接下來觀察
本文數據全部來自騰訊官方頁面、GitHub README、Hugging Face 模型卡與 arXiv 技術報告,屬當事方資料;技術報告為預印本,未經同儕審查。模型卡未載明上下文長度與硬體需求,僅列出 vLLM v0.31.0 與 SGLang 的部署方式。接下來可觀察 Mem0、MemOS 等框架是否正式支援以此模型作為寫入者、獨立評測是否在完整題集上重現,以及 MemHub 的資料處理說明是否補齊。