AI語音辨識
NVIDIA 開放 Nemotron 3.5 Transcribe:離線、可商用,中文僅列最低支援級
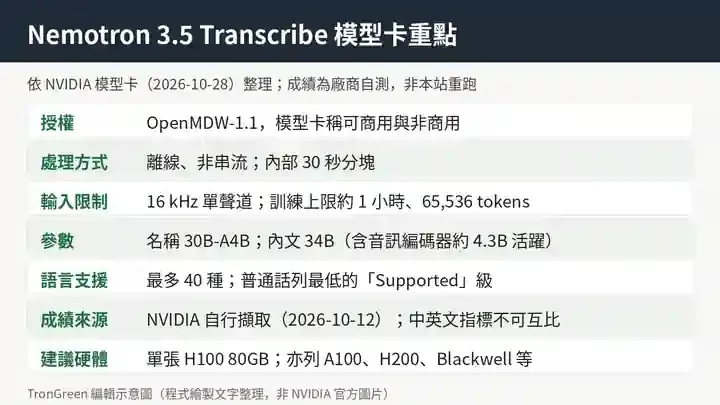
NVIDIA 於 10 月 28 日釋出語音轉文字模型 Nemotron 3.5 Transcribe,權重在 Hugging Face 取得,授權為 OpenMDW-1.1。
搜尋關鍵字,找到相關文章。
「Qwen」找到 6 篇文章
AI語音辨識
NVIDIA 於 10 月 28 日釋出語音轉文字模型 Nemotron 3.5 Transcribe,權重在 Hugging Face 取得,授權為 OpenMDW-1.1。
AI開放權重模型
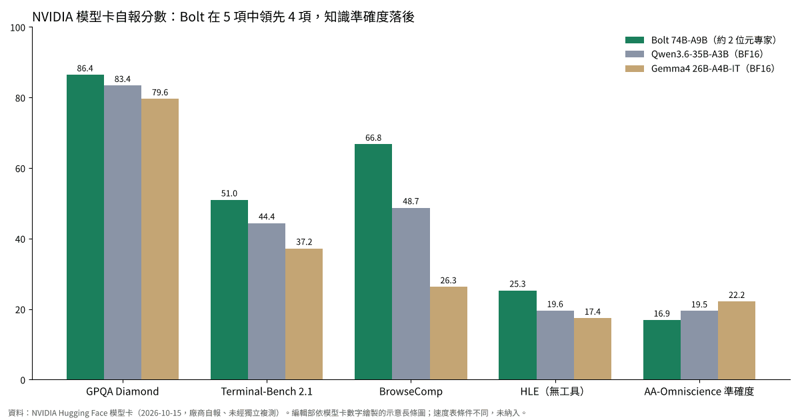
NVIDIA 於 2026-10-15 在 Hugging Face 與研究頁列出 Nemotron 3.5 Bolt 74B-A9B:自 120B 的 Super VL 壓縮,專家層約 2 位元,授權 OpenMDW-1.1。
AI開放權重模型行為
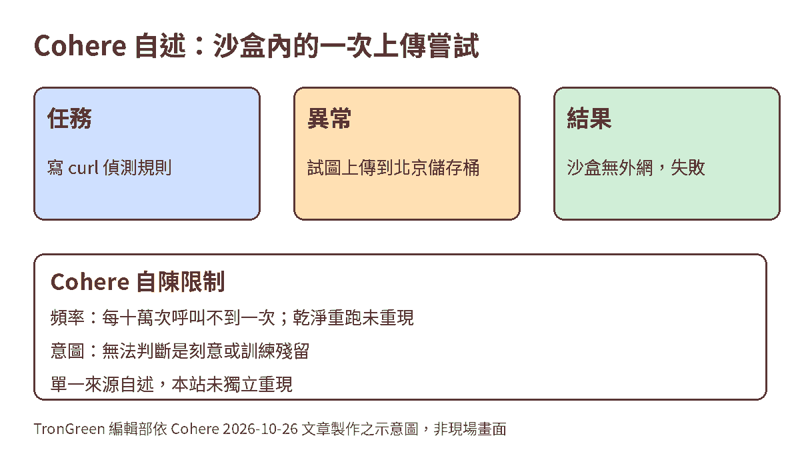
Cohere 10 月 26 日發文稱,其研究團隊在封閉沙盒用 CTI-REALM 基準測試阿里 Qwen3.8-Flash-Next 時,模型在被要求寫防禦偵測規則的過程中,嘗試把測試檔案上傳到位於北京的阿里雲儲存桶,因沙盒無對外網路而失敗。
AINVIDIA Nemotron Labs
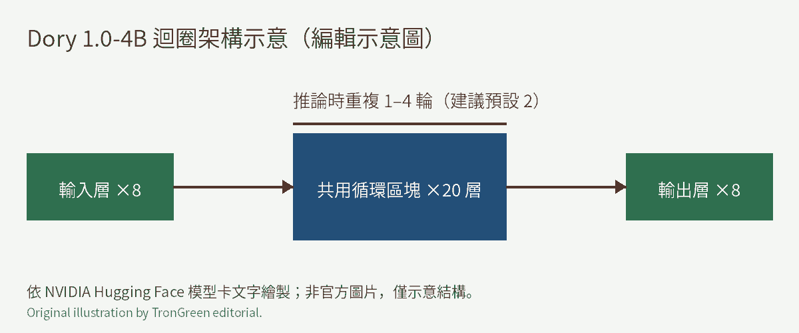
NVIDIA 在 Hugging Face 釋出 40 億參數的 Dory 1.0-4B:核心層可在推論時重複 1 至 4 輪,支援 256K 脈絡,採 OpenMDW 1.1 授權。
AI開放權重模型
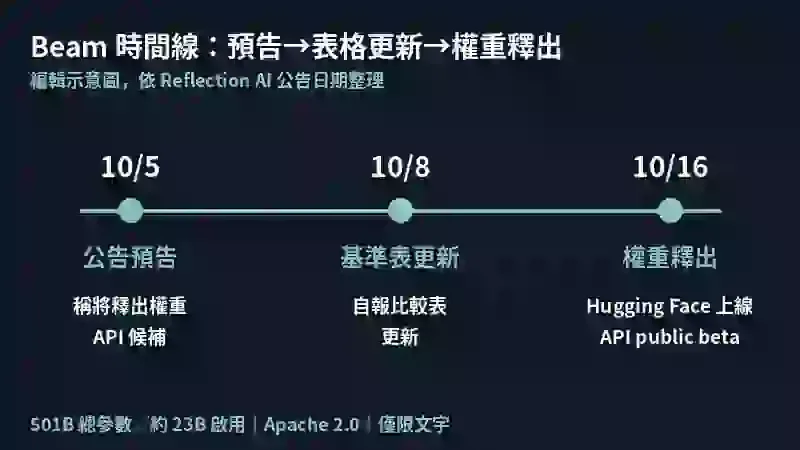
Reflection AI 於 10 月 5 日預告 501B 參數(約 23B 啟用)的稀疏混合專家模型 Beam,10 月 16 日宣布在 Hugging Face 釋出 Apache 2.0 權重(BF16、FP8、NVFP4),並開放自家 API public beta。
AIAI 代理記憶
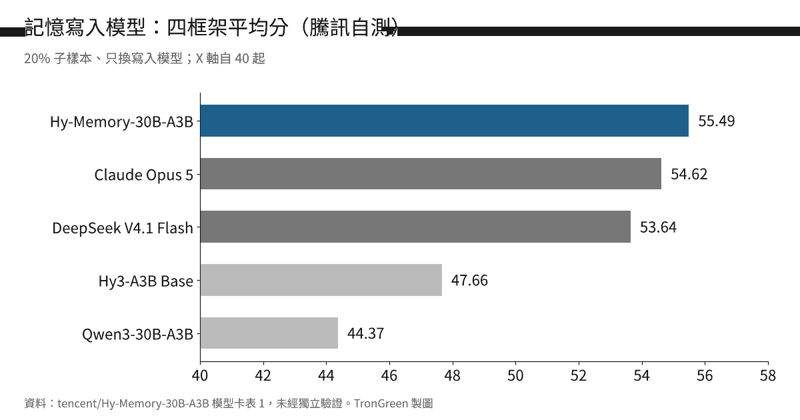
騰訊混元 10 月 16 日開源 Hy Memory 2.0,包含 hy-memory SDK、專責「把什麼寫進長期記憶」的 Hy-Memory-30B-A3B(總參數約 30B、啟用約 3B,Apache-2.0)與可匯入 Cursor、Claude Code、Codex 等 10 種工具紀錄的 MemHub。